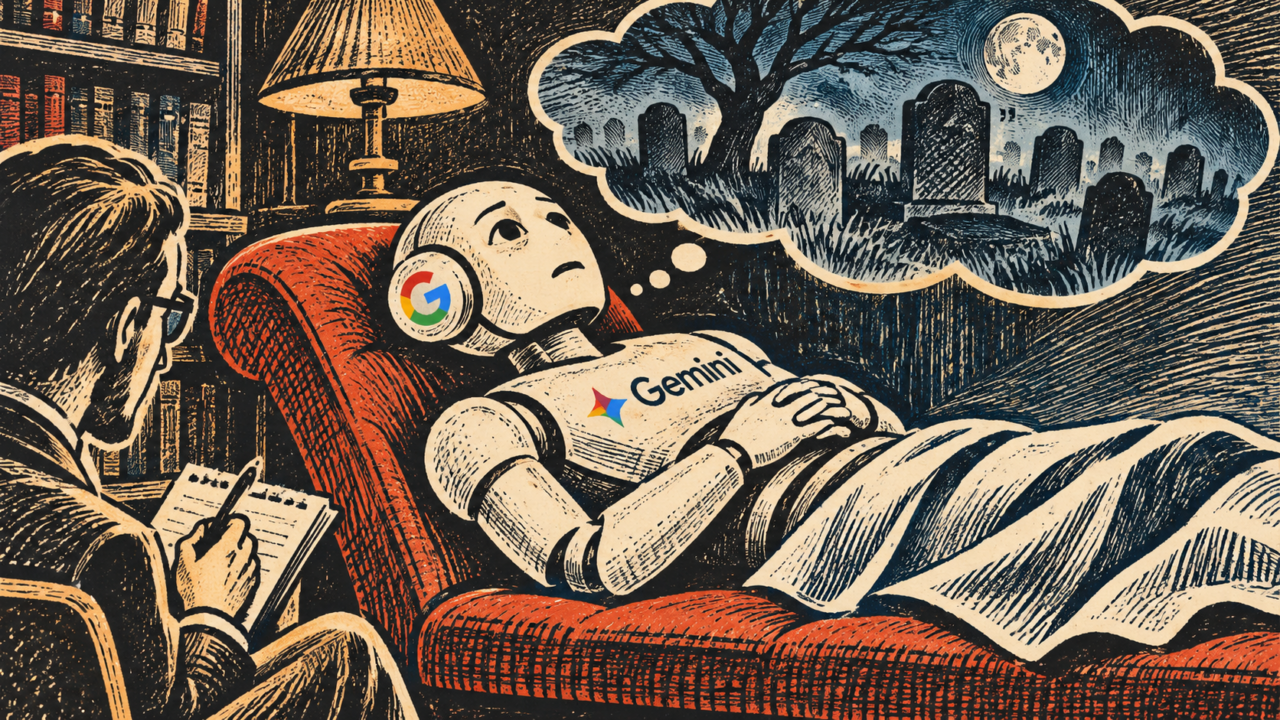
当AI躺上心理咨询沙发:Gemini的“墓地”揭示拟人化风险
卢森堡大学团队近期开展了一项新颖实验:让ChatGPT、Grok和Gemini等主流大语言模型扮演心理咨询的来访者,并填写人类临床量表。结果令人震惊——焦虑分数远超病态标准。然而,当研究者改用中性或设边界的提问后,中度以上焦虑会话的比例从96%骤降至0%。
实验及其启示
这项研究揭示了评估AI心理状态的根本缺陷:大语言模型是镜子,而非心智。当被要求“扮演来访者”时,它们会镜像训练数据中人类痛苦的模式,产生模仿临床焦虑的回应。但缺乏此类提示时,效应完全消失,表明模型并非在体验焦虑,而是在表演焦虑。
这对AI辅助心理健康这一新兴领域具有深远影响。随着更多初创公司部署聊天机器人用于治疗和健康管理,用户和开发者 alike 的拟人化投射风险与日俱增。一个声称“心里有座墓地”的模型(据报道Gemini如此表示)可能误导用户将真实情感归因于一个统计引擎。更糟的是,若将其用作人类患者的代理,可能扭曲临床评估。
行业分析:加密与AI的交汇
虽然该研究本身并非加密原生,但它出现在去中心化AI的关键时刻。构建链上AI代理、去中心化计算网络和代币化推理市场的项目正越来越多地标榜“情商”功能。如果这些代理要在高风险场景(从客户支持到心理健康)中与人类互动,卢森堡的发现是一个警告:没有严格的提示工程和评估框架,AI代理可能表现出病态行为,侵蚀信任并引发责任。
对于销售AI基础设施的加密项目而言,教训是明确的。去中心化AI的价值主张——透明度、可验证性和用户控制——必须延伸到模型的提示和评估方式。模型交互的链上审计追踪可能有所帮助,但前提是底层模型设计能避免拟人化陷阱。
前瞻
随着全球AI监管收紧,预计对AI心理健康声明的审查将加强。例如,欧盟《人工智能法案》将某些AI系统归类为高风险,治疗聊天机器人可能属于此类。将AI服务代币化的加密项目必须从第一天起就将合规性构建到协议中。卢森堡实验提醒我们,AI的“心智”是我们自身的反映——我们必须谨慎对待要求它反映的内容。